Decisiones prácticas sobre IA y software
Guías técnicas para elegir modelos, verificar software y planificar entregas.
Buscar en todos los artículos
Busca en el texto completo de los artículos.
Ningún artículo coincide con tu búsqueda. Prueba con otro término o elige un tema.
Artículos recientes
Nuevas comparaciones, guías prácticas y experiencias de ingeniería.
 IA y agentes
SuperPenguin: costes de IA por PR, cliente y función
Relaciona el gasto de Claude Code, Codex y Cursor con el trabajo entregado y el coste de API por cliente. Ejemplos, límites y un piloto para decidir con datos.

 IA y agentes
Claude Dashboards y Motion: de métricas a vídeos
Convierte una métrica de producto revisada en una breve actualización animada. Un flujo práctico con Claude Dashboards y Motion, un ejemplo por cohortes, dos prompts y reglas para compartir.
 IA y agentes
OpenAI Intelligent UI vs OpenUI: UI generativa para empresas
La nueva interfaz de ChatGPT plantea una pregunta práctica: ¿cómo convertir vistas generadas en flujos de negocio fiables? Compara API, acciones, persistencia y evaluación.
 Entrega y QA
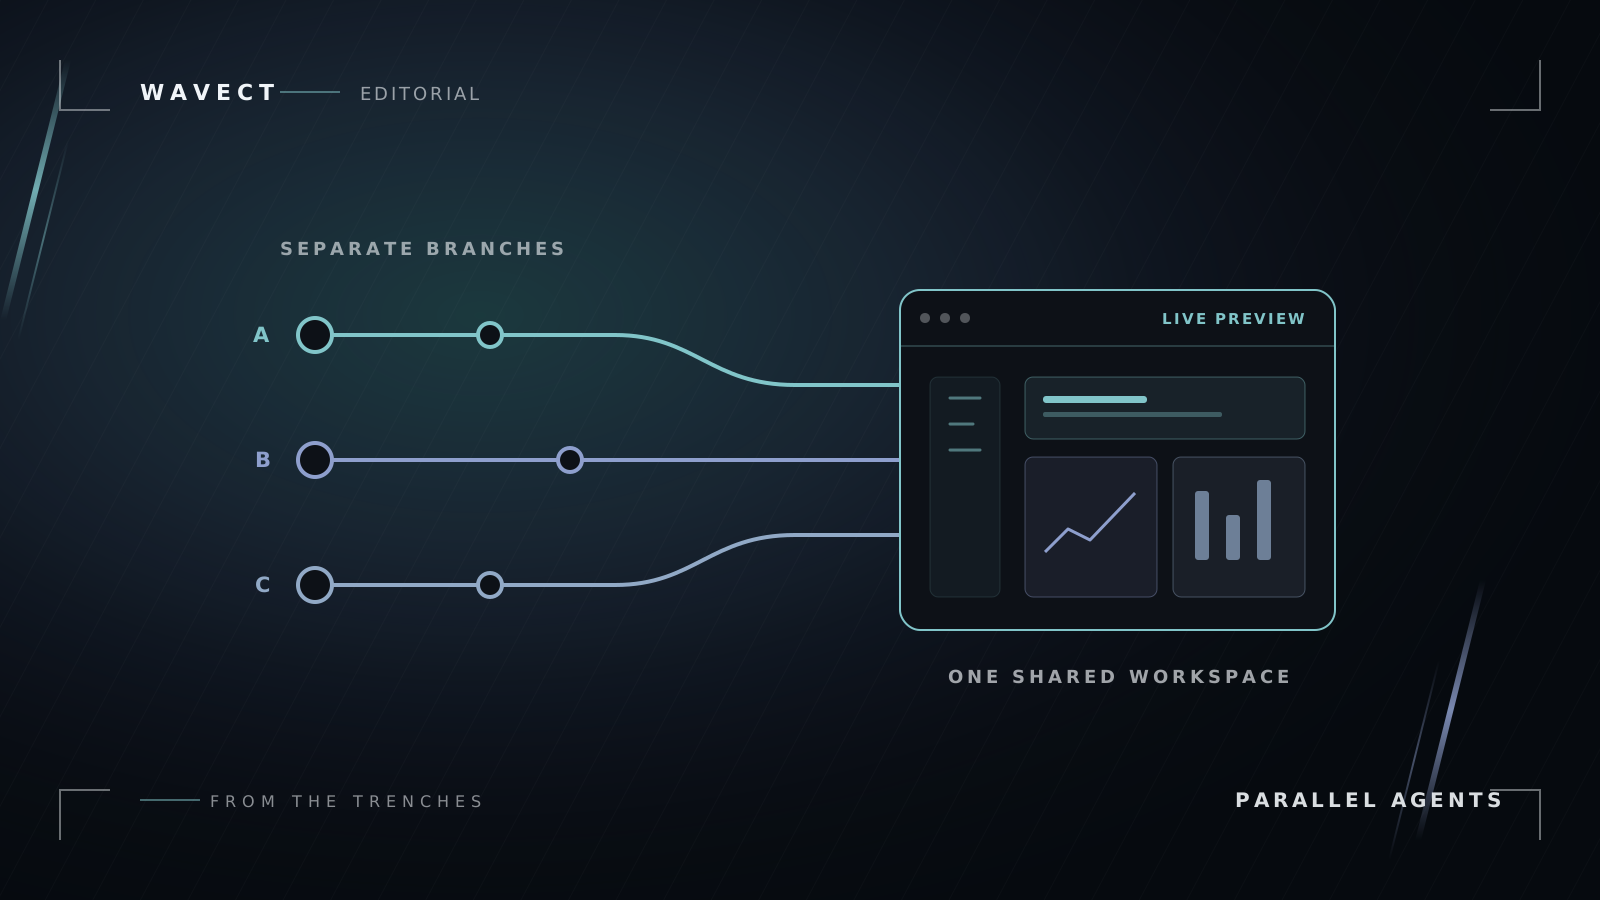
GitButler para agentes de IA en paralelo: varias ramas, una compilación
Deja que los agentes trabajen en ramas separadas dentro de una aplicación en ejecución. Conoce la CLI, las dependencias ocultas, las pruebas de ramas y lo que aún necesita el desarrollo multiplayer.
 Entrega y QA
Greptile Base, Plus o Apex: presupuesto de revisión de PR
Elige la profundidad de Greptile según el riesgo. Compara créditos, reglas de monorepo, defectos confirmados y tiempo de revisión humana.
 IA y agentes
Wally de RunAnywhere: coste por tarea de código aceptada
Evalúa Wally por tareas terminadas, reintentos y coste total. Distingue inferencia alojada y local, y compara proveedores con criterios equivalentes.
 Entrega y QA
Vendo para SaaS: aislamiento de clientes y aprobaciones
Diseña una integración Vendo con dos organizaciones, cambios de rol, aprobaciones y reinicios. Define qué responsabilidades siguen siendo de tu equipo.
 Entrega y QA
Arga Labs vs Archal: pruebas de integración con estado
Compara Arga y Archal con un flujo GitHub-Slack que verifica eventos duplicados, interrupciones, permisos y restablecimiento de datos.
 Entrega y QA
Canary AI QA: medir defectos, no puntos de benchmark
Evalúa Canary junto a Claude Code o Codex con defectos conocidos, controles limpios y pruebas ejecutadas. Interpreta correctamente QA-Bench v0.
Recibe la próxima nota de campo
Un correo breve cuando publiquemos. Sin píxeles de seguimiento ni contenido de relleno.