Modelos e infraestructura
Selección de modelos, economía de inferencia, despliegue local, compresión y serving.
- Artículos del blog
- 57
- Tema
- IA y agentes
Empieza por el artículo fundamental
Recibe la próxima nota de campo sobre IA y agentes
Un correo breve cuando publiquemos. Sin píxeles de seguimiento ni contenido de relleno.
Lo último en esta colección
 IA y agentes
Laya vs Jev: benchmarks y riesgo para startups de IA
¿Puede un especialista abierto cuestionar dos años de ventaja? Lo que demuestra Laya, los límites de la comparación con Jev y el valor que una startup puede defender.
 IA y agentes
Jev AI: análisis del modelo de decisión para agentes
Jev toma decisiones tipadas en vez de generar prosa. Descubre cómo puede enrutar modelos, controlar pasos de agentes y apoyar automatización acotada sin sustituir reglas duras.
 IA y agentes
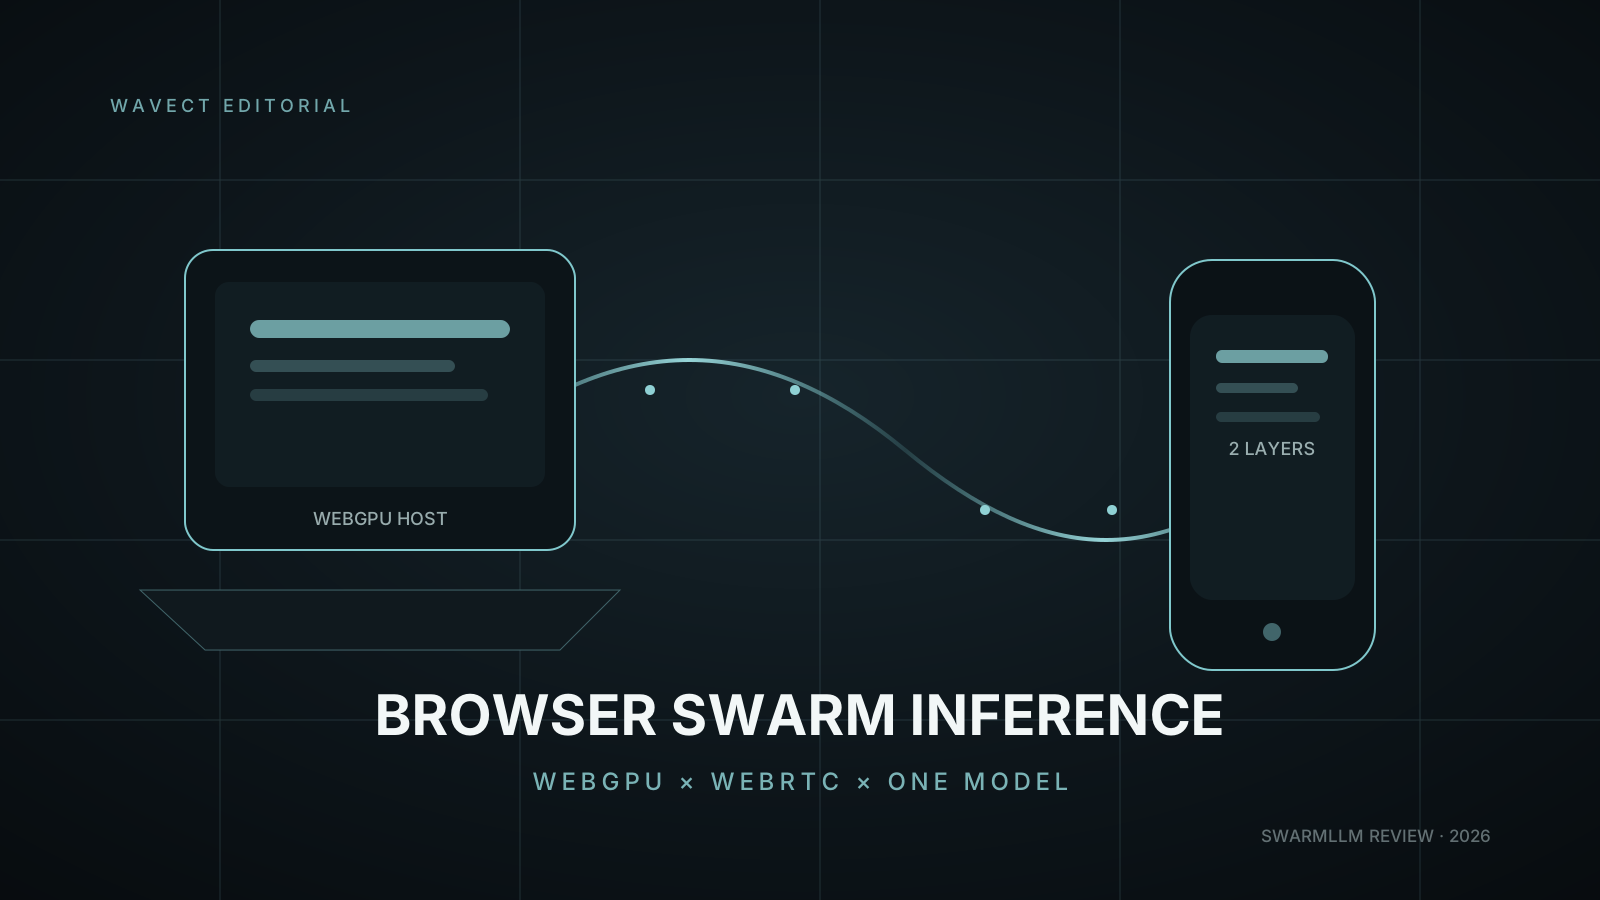
SwarmLLM Review 2026: Inferencia LLM P2P entre móvil y portátil
Review para compradores de SwarmLLM: inferencia 27B en navegador, WebGPU/WebRTC, límites de benchmark, confianza entre peers, seguridad y plan de piloto.
 IA y agentes
Review de Phonely Alma: ¿Está listo el LLM de voz para producción?
Alma anuncia 182 ms de TTFT, 206 ms de P99 y 0,55 USD por millón de tokens mixtos. Analizamos la evidencia y diseñamos un piloto para compradores.
 IA y agentes
Utopia: evaluar un grafo bitemporal empresarial
Evalúa Utopia para conocimiento empresarial: historial bitemporal, evidencia, límites del autoalojamiento y un piloto concreto antes de invertir.
 IA y agentes
NVIDIA PAIR: Routing de IA Local y la Brecha de AMD
PAIR enruta peticiones independientes entre ordenadores locales sin agrupar GPUs. Analizamos cómo funciona, el límite de Strix Halo y qué debe probar un port para AMD.
Directorio completo de artículos
- Laya vs Jev: benchmarks y riesgo para startups de IA
- Jev AI: análisis del modelo de decisión para agentes
- SwarmLLM Review 2026: Inferencia LLM P2P entre móvil y portátil
- Review de Phonely Alma: ¿Está listo el LLM de voz para producción?
- Utopia: evaluar un grafo bitemporal empresarial
- NVIDIA PAIR: Routing de IA Local y la Brecha de AMD
- Análisis de Tencent Hy4 Preview: ¿Merece un piloto con contexto de 1M?
- PageLM: autoalojamiento y uso comercial
- Mac mini M6 vs Mac Studio M5 para IA local: guía de compra
- Análisis de FreeToken AI: ¿modelos MoE frontier en una GPU doméstica?
- Darkbloom AI: Inferencia Privada en Macs Inactivos
- Ox Alpha era GLM-5.3-Flash: qué ha cambiado
- Precios de Pika Audio API: ¿SFX cuesta de verdad 20 veces menos?
- La apuesta de $13M de Thunder Compute por virtualizar GPUs: guía de compra
- AirLLM con 4 GB de VRAM: cómo funciona la inferencia por capas
- Qwen3.8-27B: agentes de computer use autoalojados sin exportar capturas
- El stack vLLM y Triton de Netflix: 7 lecciones de producción
- Transformers.js en el navegador: cuándo llevar la IA local a tu producto
- Cómo autoalojar LiteLLM en producción: guía 2026
- Wiki empresarial preparada para IA: arquitectura e implementación
- ¿Claude añade marcas de agua al texto? Respuesta API 2026
- Review de OpenKB: compilador de conocimiento vs RAG
- Unsloth Desktop: ¿workstation privada de IA local?
- NeMo Switchyard 0.2: ¿routing de agentes sin entrenar?
- Firecrawl AnyDoc: 14 formatos a Markdown
- Muse Glimmer 30B: ¿está listo el agente local de Meta para producción?
- Routing de IA con OmniRoute: Setup y Checklist de Producción
- Gemini Robotics 2: control corporal completo y decisión de piloto
- pdf-inspector: parser PDF local antes del OCR
- Asistente de programación con IA local multimodal: voz, OCR y privacidad
- DeepSeek V4 Flash 0731 en un PC de IA: ¿qué funciona?
- Cómo afinar Gemma 4 gratis con Unsloth y Colab
- Taalas HC1 a examen: ¿compensa un ASIC para un solo LLM?
- ¿Qué LLM local puedes ejecutar? Guía de llmfit para tu hardware
- Miso TTS autoalojado vs API: coste, latencia y VRAM
- Comprime vectores RAG a 2 bits: ¿está lista para producción la cuantización sin datos?
- LMCache reportó un TTFT medio 13,7x menor con una caché KV compartida
- Compresión LLM sin Pérdida vs 8-bit GGUF: ¿Qué Está Listo?
- Review de Cisco Antares: IA local 1B para localizar vulnerabilidades
- NVIDIA Nemotron 3.5 ASR: ¿Está listo el STT self-hosted para voice agents?
- Kimi K3 para Empresas de la UE: Coste API, Datos y Plan de Piloto
- Mesh LLM: ¿Puede un LLM Ejecutarse en Varios Ordenadores?
- Review de Bonsai 27B: ¿Puede un LLM de 27B Ejecutarse en un Móvil?
- Soofi S: ¿Está listo para empresas el LLM soberano de Alemania?
- Colibri Ejecuta GLM-5.2 en Hardware de Consumo. Esta Es la Trampa.
- Cuándo los Modelos Locales Superan a las APIs: Calculadora Break-Even para Empresas de la UE
- Calculadora de Costes LLM 2026: Coste por Tarea, No por Token
- Review de Pxpipe: ¿reduce un 60% el coste de Claude Code?
- Más barato por token todavía puede costar más por tarea
- Anthropic rechaza prohibir pesos abiertos. La guerra de costes sigue.
- Gateways LLM Comparados 2026: LiteLLM vs OpenRouter vs Portkey vs RouteLLM
- Alojar LLMs en la UE: Cuándo Salen a Cuenta los Open Weights
- Mejores LLM de pesos abiertos 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- Cómo Reducir los Costes de Tokens LLM en 2026
- ¿Cuándo vale la pena construir un eval de LLM? Coste, ROI y confiar en el juez
- ¿RAG, fine-tuning o contexto largo? Comparativa 2026
- Costes de APIs LLM 2026. Cambio de Arquitectura