AI und Agents
Engineering, Betrieb und Bewertung von AI-Systemen, Coding Agents und Modellinfrastruktur.
- Blogbeiträge
- 137
- Fokussierte Cluster
- 02
Fokussierte Cluster
Mit dem Grundlagenartikel starten
- Graph Engineering für KI-Agenten: Wann lohnt sich ein Knowledge Graph?Entscheidungshilfe zu Agent Graphs, Experiment-DAGs und Knowledge Graphs: wann du sie weglassen solltest, was Provenance verlangt und wie du einen messbaren Pilot planst.
- LLMs in der EU selbst hosten: Wann sich Open Weights wirklich rechnenDie GPU ist der günstige Teil. Hier sind die echten Kosten, eine belastbare Break-even-Formel, die DSGVO-Trade-offs und der vLLM-Produktions-Stack.
Erhalte die nächste Feldnotiz zu AI und Agents
Eine kurze E-Mail, wenn wir veröffentlichen. Ohne Tracking-Pixel und ohne Postfachfüller.
Neu in dieser Sammlung
 KI & Agenten
Laya vs Jev: Benchmarks und das Risiko für KI-Startups
Kann ein offener Spezialist zwei Jahre Vorsprung gefährden? Was Laya tatsächlich zeigt, was im Jev-Vergleich fehlt und wo belastbarer Kundennutzen entsteht.
 KI & Agenten
Google AX Agent Executor: Budgets und Selbsthosting
Eine Sandbox ist kein Kostenlimit. Was Google AX kontrolliert, welcher Zustand erhalten bleibt und welche Abhängigkeiten für die eigene KI entscheidend sind.
 KI & Agenten
WikiSkill: Wie Agenten SKILL.md aus Erfahrung weiterentwickeln
WikiSkill verdichtet Agenten-Traces zu einem persistenten Evidenz-Wiki und validiert atomare Änderungen an SKILL.md. Wir prüfen Benchmarks, Transfer, Grenzen und Produktionsarchitektur.
 KI & Agenten
Tencent Octop im Review: Was Entwickler tatsächlich kostenlos bekommen
Tencent stellt Octop unter MIT bereit, inklusive Multi-User-Agenten, Dashboard, Automatisierung und Speicherung. Wir prüfen Lieferumfang, Grenzen und reale Produktionskosten.
 KI & Agenten
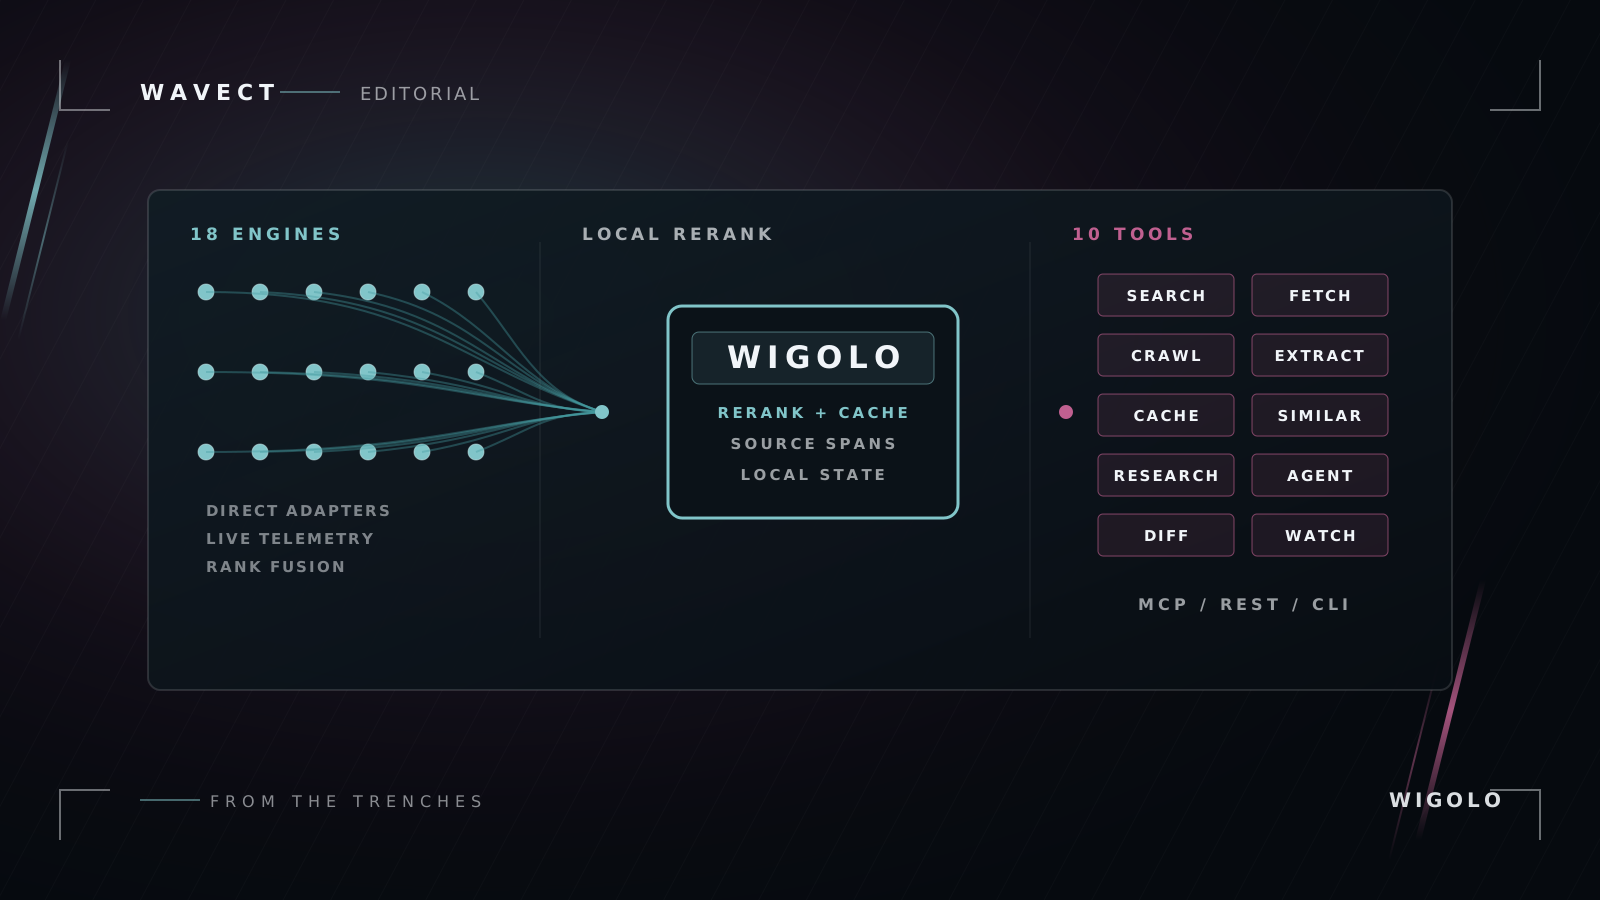
Wigolo im Test: Lokale Web Intelligence für AI Agents
Wigolo bietet AI Agents lokale Suche, Fetching, Crawling und Research ohne Paid Search API. Wir prüfen zehn Tools, Cache, Datenschutz, AGPL und Produktionsgrenzen.
 KI & Agenten
Jev AI im Test: Entscheidungsmodelle für Agenten
Jev trifft typisierte Entscheidungen statt Prosa zu erzeugen. So kann es Modelle routen, Agentenschritte steuern und begrenzte Automatisierung ergänzen, ohne harte Regeln zu ersetzen.
Vollständiges Artikelverzeichnis
- Laya vs Jev: Benchmarks und das Risiko für KI-Startups
- Google AX Agent Executor: Budgets und Selbsthosting
- WikiSkill: Wie Agenten SKILL.md aus Erfahrung weiterentwickeln
- Tencent Octop im Review: Was Entwickler tatsächlich kostenlos bekommen
- Wigolo im Test: Lokale Web Intelligence für AI Agents
- Jev AI im Test: Entscheidungsmodelle für Agenten
- Supermemory: KI-Agenten mit Gedächtnis, RAG und lokalem Betrieb
- KI-Agenten-Designmuster: Einfach starten, Aktionen prüfen
- Claude Mods: Einrichtung, Function Hooks und Sicherheit
- Voicebox: Lokales Voice Cloning, Diktieren und MCP-Setup
- Valyus 0,6B-Router für Retrieval-Agenten: Ergebnisse, Grenzen und Einsatz
- OpenAI Agents API im Review: Migration, Kosten und Datenkontrollen
- Spotify shunt: Einrichtung, Token-Ersparnis und Grenzen
- OpenBot im Check: KI-Kollegen selbst hosten
- SwarmLLM Test 2026: Browser-P2P-Inferenz auf Smartphone und Laptop
- Ramp Inspect Architektur 2026: Background Coding Agents skalieren
- Model Hardware Standard: MHS für Physical AI im Unternehmen
- Fonio AI Erfahrungen 2026: Preise, API, DSGVO & Build vs Buy
- Mosaic (YC S26) im Check: Shared Memory für Coding Agents
- Ripwire Review 2026: Repo-Kontext für KI-Agenten ohne Embeddings?
- Atomare Multi-Datei-Edits für KI-Coding-Agenten: die Semaprax-Lektion
- Phonely Alma im Test: Ist das Voice-LLM produktionsreif?
- Utopia: Temporalen Wissensgraph im Unternehmen prüfen
- Wissenstransfer zwischen KI-Agenten: Einmal entdecken, günstiger skalieren
- claude-rotate: Ein Proxy für mehrere Claude-Max-Konten
- NVIDIA PAIR im Test: Lokales KI-Routing und die AMD-Lücke
- Feynman im Test: Ist der Open-Source AI Research Agent bereit für Teams?
- Obscura Browser im Test: Aussagen, Grenzen und Produktions-Fit
- Claude-Code-Designsystem: 4 Bausteine für markentreue UI
- Tencent Hy4 Preview im Test: Lohnt sich das 1M-Kontextmodell?
- PageLM im Check: Selbst hosten und kommerziell nutzen
- ChatGPT-Login: Das Modell sieht dein Passwort nicht
- M6 Mac mini vs. M5 Mac Studio für lokale KI: Kaufberatung
- KI-Agenten-Harness erklärt: Die Zuverlässigkeitsschicht rund um ein LLM
- FreeToken AI im Test: Frontier-MoE auf Consumer-GPUs?
- Darkbloom AI Test: Private Inferenz auf freien Macs
- Ox Alpha als GLM-5.3-Flash enthüllt: Was sich ändert
- Warum Agenten-Edits semantische Identität brauchen: SEMAPRAX in Rust
- LangChain Deep Agents im Test: Ist das Agent Harness produktionsreif?
- Pika Audio API Preise: Sind Soundeffekte wirklich 20x günstiger?
- Thunder Computes 13-Mio.-Dollar-Wette auf GPU-Virtualisierung: Einkaufsleitfaden
- OpenViking im Überblick: Dateisystem-Memory für KI-Agenten
- LLM-as-a-Verifier erklärt: Architektur, Kosten und Produktionseinsatz
- AirLLM mit 4 GB VRAM: So funktioniert Layer-wise Inference
- TrueForge im Test: Ist das Open-Source Agent Harness produktionsreif?
- Agentenlesbare Websites: llms.txt, Markdown-Spiegel und was kaputtgeht
- Qwen3.8-27B: Computer-Use-Agenten selbst hosten, ohne Screenshots zu exportieren
- Lokalisierte URL-Slugs und hreflang: Warum wir einen englischen Slug behalten
- Kann ein KI-Agent dein Produkt benutzen, oder nur darüber lesen?
- Graft Review 2026: Gehört die Repo-Map ins Git?
- Wie du Coding-Agenten mit Tool-Ausgabe-Kompression skalierbar machst
- Intelligenterer Token-Einsatz mit deinem AI-Coding-Agenten
- DeepSeek Harness im Test: Ist der Plugin-Stack produktionsreif?
- Der vLLM- und Triton-Stack von Netflix: 7 Produktionslektionen
- OpenSandbox im Review: Lohnt sich Self-Hosting?
- Transformers.js im Browser: Wann lokale KI in dein Produkt gehört
- Cloudflare Kitesurf im Test: Kosten, Grenzen und Produktions-Fit
- GitHub Spec Kit im Test: Lohnt sich der Prozess?
- Interner KI-Agenten-Marktplatz: Praxisleitfaden 2026
- LiteLLM selbst hosten: Production-Guide 2026
- KI-fähiges Unternehmenswiki: Architektur und Aufbau
- Ist Linux das beste Betriebssystem für KI-Agenten? Infrastruktur-Guide 2026
- Versieht Claude Texte mit Wasserzeichen? API-Antwort 2026
- OpenKB Review: Knowledge Compiler vs. RAG
- Unsloth Desktop im Test: Private lokale KI-Workstation?
- NeMo Switchyard 0.2: Agenten-Routing ohne Training?
- Firecrawl AnyDoc im Test: 14 Formate zu Markdown
- MCP Cloud vs. Manufact Cloud: MCP-Hosting-Ratgeber
- Muse Glimmer 30B: Ist Metas lokales Agentenmodell produktionsreif?
- KI-Texte menschlicher schreiben mit Agent Skills
- NVIDIA NOOA im Test: Sind objektorientierte Agenten produktionsreif?
- OmniRoute KI-Routing: Setup und Produktions-Checkliste
- Strix AI Pentesting: 30-Tage-Pilot und Kaufguide 2026
- Hyperagent im Test: Cloud-KI-Agenten ohne eigenen Server
- Gemini Robotics 2: Ganzkörpersteuerung und die Pilotentscheidung
- Hark Handoff im Test: Der Agent, der wirklich klickt
- Meta Muse Code Preise: Ist Contributor für Kundencode sicher?
- pdf-inspector im Test: PDFs vor OCR lokal routen
- PII vor LLM-Prompts entfernen: Eine praktische Pipeline
- Agent Reach im Test: Kosten, Sicherheit und Grenzen
- Cloudflare Wallets für KI-Agenten: Was ist live?
- Lokaler multimodaler KI-Coding-Assistent: Sprache, OCR und Datenschutz
- DeepSeek V4 Flash 0731 auf einem KI-PC: Was funktioniert?
- YC QM Agent im Test: Ist Quartermaster bereit?
- jcode vs Claude Code: Lohnt sich der Wechsel zum Rust-Harness?
- Lightpanda Browser für KI-Agenten: Praxischeck 2026
- Graph Engineering für KI-Agenten: Wann lohnt sich ein Knowledge Graph?
- Multi-Modell KI-Coding-Agent-Stack: Kaufleitfaden für Teams
- Ist MCP jetzt stateless? Deine Server-Migrationscheckliste
- MCP ist keine Sicherheitsgrenze: Agentendaten schützen
- Gemma 4 kostenlos mit Unsloth und Colab tunen
- Können KI-Agenten miteinander kommunizieren? Band-Guide
- Taalas HC1 im Check: Lohnt sich ein fest verdrahteter LLM-ASIC?
- LeanCTX Erfahrung aus Agentur-Sicht: technischer Praxisbericht
- Welches lokale LLM läuft auf deiner Hardware? llmfit Guide
- GPT-5.6 Sol mit CLIProxyAPI in Claude Code nutzen
- Miso TTS selbst hosten oder API: Kosten, Latenz und VRAM
- Enterprise MCP Authorization: Multi-Tenant-Referenzarchitektur
- RAG-Vektoren auf 2 Bit komprimieren: Ist datenunabhängige Quantisierung produktionsreif?
- LMCache meldet 13,7x niedrigere mittlere TTFT mit gemeinsamem KV Cache
- Verlustfreie LLM-Kompression vs. 8-bit GGUF: Was ist produktionsreif?
- OpenAI Eval-Sandbox-Escape: 12 Kontrollen für Cyber-Agenten
- Cisco Antares im Test: 1B Local AI für Vulnerability Localization
- Meterless im Test 2026: Ist der Context Layer produktionsreif?
- NVIDIA Nemotron 3.5 ASR: Ist Self-Hosted STT bereit für Voice Agents?
- Claude Code vs OpenCode: Was kostet dein Team 2026 weniger?
- Kimi K3 für EU-Unternehmen: API-Kosten, Datenschutz und Pilotplan
- Mesh LLM im Test: Ein großes LLM auf mehreren Rechnern ausführen?
- Graphify Review 2026: Lohnt sich ein Knowledge Graph für deine Codebasis?
- Bonsai 27B im Test: Läuft ein 27B-LLM wirklich auf dem Smartphone?
- KI-Pilot Kill-or-Scale-Scorecard: 12 Kennzahlen nach 30 Tagen
- Soofi S: Ist Deutschlands souveränes LLM bereit für Unternehmen?
- T3MP3ST Review 2026: Ersetzt es einen Penetrationstest?
- Colibri führt GLM-5.2 auf Consumer-Hardware aus. Der Haken.
- Open Knowledge Format (OKF): Der Unternehmensleitfaden
- AI Agent Cost per Action: Warum agentische Workflows Token-Rechnungen sprengen
- Wann lokale Modelle APIs schlagen: Break-even-Rechner für EU-Unternehmen
- LLM-Kostenrechner 2026: Rechne pro Aufgabe, nicht pro Token
- Pxpipe im Test: Senken Bilder Claude-Code-Kosten um 60%?
- Pro Token günstiger kann pro Aufgabe teurer sein
- Claude Fable 5.1 in Claude Code nutzen
- Anthropic sagt Nein zum Open-Weights-Verbot. Der Kostenkampf bleibt real.
- Was ein interner KI-Assistent in der DACH-Region wirklich kostet (2026)
- LLM-Gateways im Vergleich 2026: LiteLLM vs OpenRouter vs Portkey vs RouteLLM
- LLMs in der EU selbst hosten: Wann sich Open Weights wirklich rechnen
- Beste Open-Weight-LLMs 2026: DeepSeek vs Qwen vs Kimi vs GLM vs Llama
- Der Engpass war nie Intelligenz. Es war Kontext.
- ChatGPT Enterprise vs. Copilot vs. eigenes RAG
- MCP, RAG, Agent Skills oder Custom GPTs?
- LLM-Token-Kosten 2026 senken
- KI-Agent-Pilot in 30/60/90 Tagen
- RAG über SharePoint, Confluence, Drive: Permissions-First
- RAG-Production-Readiness-Checkliste für EU-Unternehmen
- Wann lohnt es sich, ein LLM-Eval zu bauen? Kosten, ROI und dem Judge vertrauen
- Warum KI-Agentenprojekte abgebrochen werden
- RAG, Fine-Tuning oder Long Context? Vergleich 2026
- LLM-API-Kosten 2026. Architektur-Shift