Praktische Entscheidungen für KI und Software
Technische Leitfäden zur Modellauswahl, Softwareprüfung und Projektplanung.
Alle Artikel durchsuchen
Durchsuche den gesamten Artikeltext.
Keine Beiträge zu deiner Suche. Probier einen anderen Begriff oder wähl ein Thema.
Neueste Artikel
Neue Vergleiche, praktische Leitfäden und Erfahrungen aus der Entwicklung.
 KI & Agenten
SuperPenguin: KI-Kosten pro PR, Kunde und Feature
Was kostet die Entwicklung eines Features, was seine Nutzung? So verbindet SuperPenguin Coding-Aktivität, Kundenmetadaten und Rechnungen zu belastbaren Kostennachweisen.

 KI & Agenten
Claude Dashboards + Motion: Von KPIs zum Video
Aus einer geprüften Produktkennzahl wird ein kurzes animiertes Update. Ein konkreter Workflow mit Claude Dashboards und Motion, Kohortenbeispiel, zwei Prompts und Freigaberegeln.
 KI & Agenten
OpenAI Intelligent UI vs. OpenUI: Generative UI für Business-Apps
ChatGPTs neue Oberfläche wirft eine praktische Frage auf: Wie werden aus generierten Ansichten verlässliche Geschäftsprozesse? Ein Vergleich von APIs, Aktionen, Zustandsspeicherung und Abnahmekriterien.
 Software Delivery & QA
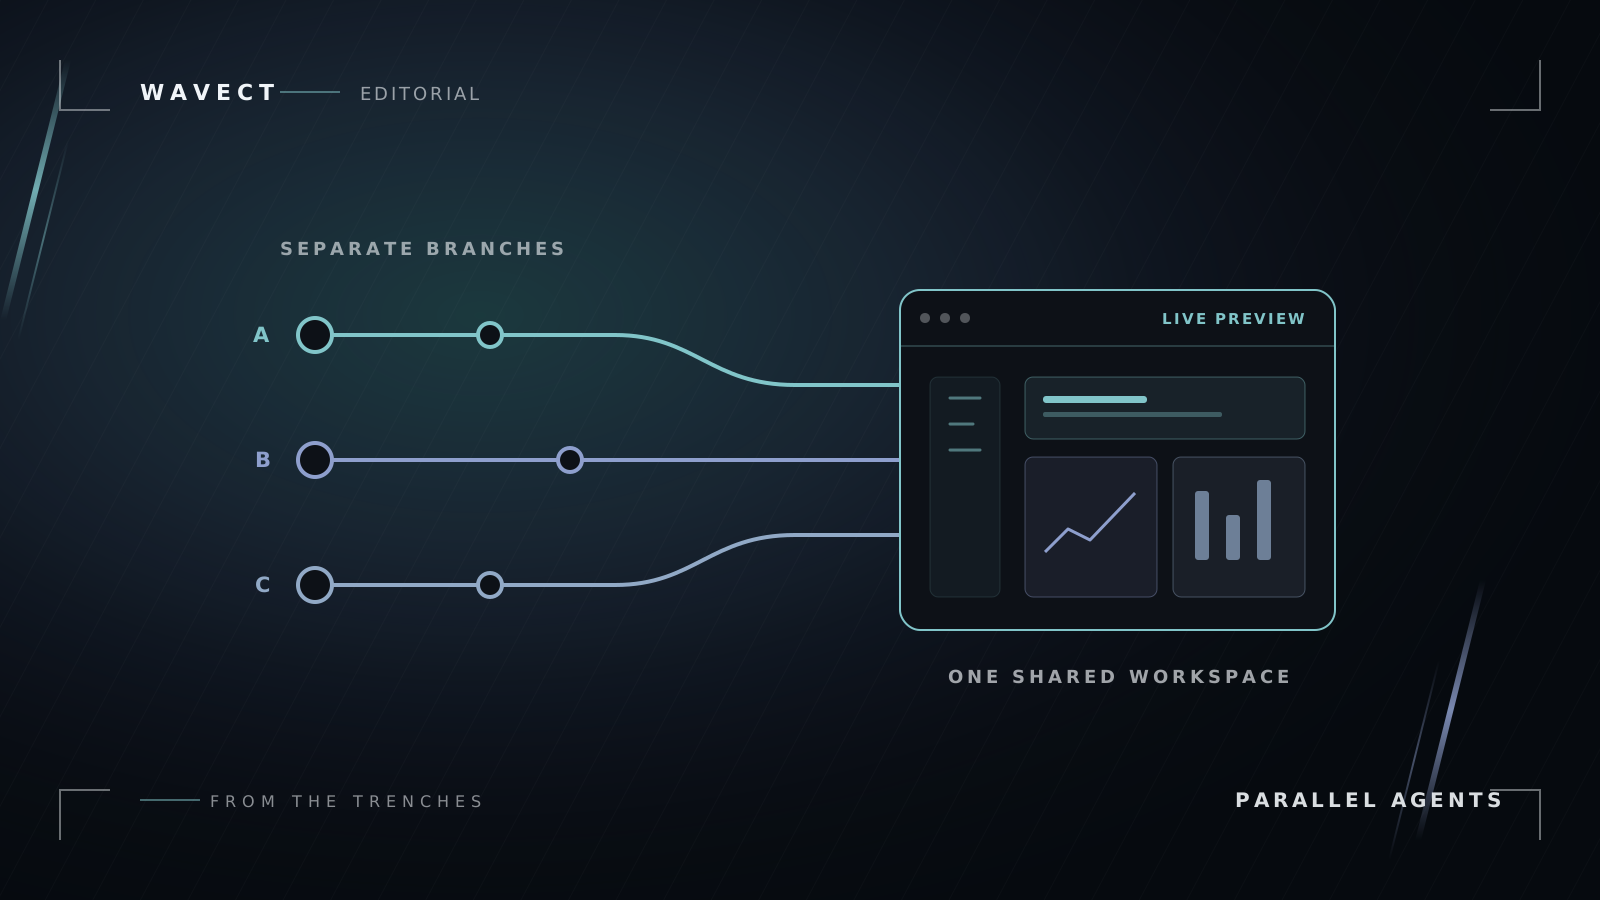
GitButler für parallele KI-Agenten: Mehrere Branches, ein Build
Lass Agenten auf getrennten Branches in einer laufenden Anwendung arbeiten. Erfahre, wie CLI-Workflow, versteckte Abhängigkeiten und Branch-Prüfungen zusammenhängen und was Multiplayer noch braucht.
 Software Delivery & QA
Greptile Base, Plus oder Apex: PR-Reviews sinnvoll budgetieren
Wähle die Greptile-Prüftiefe nach Änderungsrisiko. Vergleiche Credits, Monorepo-Regeln, bestätigte Fehler und den Aufwand für menschliche Nachprüfung.
 KI & Agenten
Wally von RunAnywhere: Kosten pro akzeptierter Coding-Aufgabe
Bewerte Wally anhand abgeschlossener Coding-Aufgaben, Wiederholungen und Gesamtkosten. Trenne gehostete Inferenz von lokaler Ausführung.
 Software Delivery & QA
Vendo für SaaS: Mandantentrennung und Freigaben
Plane eine Vendo-Integration mit zwei Mandanten, Rollenwechseln, Freigaben und Neustarttests. Kläre, welche Produktionsaufgaben bei deinem Team bleiben.
 Software Delivery & QA
Arga Labs oder Archal: Zustandsbasierte Integrationstests
Vergleiche Arga und Archal anhand eines GitHub-Slack-Ablaufs mit doppelten Events, Unterbrechungen, Berechtigungsfehlern und reproduzierbarem Zustand.
 Software Delivery & QA
Canary AI QA: Fehlererkennung statt Benchmark-Punkte prüfen
Bewerte Canary neben Claude Code oder Codex mit bekannten Defekten, fehlerfreien Kontrollen und ausgeführten Tests. Ordne QA-Bench v0 richtig ein.
Erhalte die nächste Feldnotiz
Eine kurze E-Mail, wenn wir veröffentlichen. Ohne Tracking-Pixel und ohne Postfachfüller.
Stehst du gerade vor so einer Entscheidung? Sprich sie mit uns durch →